最近在关注长程 Agent 评测时, 我开始考虑运行中断后的恢复问题. 一道题可能运行数小时, 评测框架需要保存过程中产生的进度.
我们在做的 ageval 是一个 Agent 评测框架. 它让任务脚本负责描述题目、交互和评分, 再用插件选择模型、Agent 运行程序和执行环境. 这样, 同一道题可以在相同的评分条件下, 更换模型或运行程序做对照.
 ZJU-REAL/ageval76repoA composable framework for reproducible evaluation of long-running agents.
这些组合能力已经让我们能够运行不同的 benchmark. 随着 Agent 能处理更长的任务, 运行中断的成本也随之增加. Terminal-Bench 4.0 把单题的 Agent 超时上限设为八小时. 长时间的评测会产生大量模型调用、文件修改和工具输出.
假设 Agent 已经读完代码、写了一半程序, 主进程却因为断线或机器重启退出. 下次启动评测时, 已经完成的题目可以跳过, 未完成的题目则需要恢复进度. 如果重新执行, 就需要承担额外的时间与 token 成本.
我们希望保存下来的进度能支持三种操作:
- Resume: 中断后接着跑, 复用上一轮的思考和工具调用等进度;
- Fork: 从同一进度换个模型继续, 观察两者后续的差异;
- Replay: 把已记录的终端操作放进新环境里重放, 检查结果.
下图展示评测进度的保存, 以及续跑、分支和重放时环境与运行的变化:
Loading
从 v0.10.0 开始, ageval 陆续引入活动日志、检查点、续跑、分支和动作重放. 下面记录这些设计的来龙去脉.
从 Pi Durable 开始调研#
十月初, 我看到了 Pi Durable. 它把模型调用、工具执行等工作组织为任务, 并在执行过程中保存进度. 进程重启后, 它会找到尚未完成的任务继续处理. 模型请求如果中途被截断, 可以重新发送; 工具调用则需要区分副作用. 工具只有声明可以安全重跑, 才会自动重跑; 否则模型会收到中断信息, 再决定下一步.
 earendil.comPi Durable一个关注长时间运行与进程重启的 Agent 运行框架.
Pi Durable 将模型请求、工具调用和上下文压缩都视为任务. 每个任务保存执行进度; 新进程打开同一份存储后, 就能找到尚未完成的任务. 下面的伪代码展示了它如何处理被截断的模型请求和工具调用, 恢复规则来自 Pi Durable 原文:
def recover_task(task):    if task.is_interrupted_model_request():        save_partial_answer_as_aborted(task)        return resend_model_request(task)
    if task.is_interrupted_tool_call():        # 只有声明可以安全重跑的工具才自动重试        if task.tool.replay_safe:            return rerun_tool(task)        return report_interruption_to_model(task.partial_output)
    return continue_from_checkpoint(task)
例如搜索工具声明可以安全重跑, 中断后可以再次搜索; 部署工具如果没有这个声明, Pi Durable 会把中断前收集到的输出交给模型, 让模型判断下一步. 这里保存的是任务和会话状态. 工具所在的文件系统由执行环境提供, 环境丢失后, 还需要其他机制恢复文件.
我开始考虑把这种恢复机制引入 ageval. 评测还需要保存 Agent 工作时的环境: 除了对话, 仓库里已经修改的文件、执行命令产生的结果也需要恢复. 围绕环境状态和运行记录, 我接着看了几种方案:
| 项目或方案 | 保存的主要内容 | 中断后怎样处理环境 |
|---|---|---|
| Pi Durable | 会话和任务进度 | 环境由外部接口提供, 文件状态需要另行处理 |
| Inspect | Agent 状态、事件和指定的沙箱文件 | 新建沙箱, 恢复检查点中保存的路径 |
| Harbor 的恢复 RFC | 环境句柄、运行阶段等恢复信息 | 提议重新连接仍然存活的环境 |
| SWE-agent 的动作重放 | 轨迹中记录的动作 | 在新环境里重新执行动作, 得到新的输出 |
Inspect: 在回合边界保存检查点#
Inspect 会保存 Agent 状态、事件和沙箱中指定路径的文件. 它在回合边界检查是否需要写检查点: 即使按时间触发, 也会等当前回合和工具调用结束. 下面的伪代码展示了 Inspect 如何在回合之间保存状态:
while not finished(state):    if checkpoint_trigger_fired():        agent_state = capture_agent_state()        files = capture_sandbox_paths()        # 写入检查点记录后,这次保存才可用于恢复        save_checkpoint_record(agent_state, files, events, store)
    state = await run_one_turn(state)
检查点记录写好后, 这份状态才能用于恢复. 假如工具运行了十分钟, 期间进程退出, Inspect 会回到上一个已提交的检查点; 它不会保存正在运行的工具进程. 重试时, Inspect 创建新的沙箱、执行环境初始化, 再把捕获的文件路径和 Agent 状态恢复进去.
Harbor RFC: 接回仍在运行的环境#
Harbor 的恢复 RFC提出另一种路径: 在运行开始后保存环境句柄和当前阶段, 中断后尝试通过句柄接回原来的容器或远程沙箱. 下面的伪代码展示了恢复标记、环境重连和后续阶段之间的关系:
marker = read_recovery_marker(trial)if marker is None:    return restart_trial(trial)
env = reconnect(marker.environment_handle)if env is None:    return restart_trial(trial)
if marker.phase == "verifier":    return verify(env)  # Agent 已结束,继续评分if agent_supports_resume(marker):    return resume_agent(env)return restart_trial(trial)
恢复标记记录的是环境地址和运行阶段, 本身不包含文件快照. 这个流程依赖原环境仍然存活: 环境还在时, 文件和正在运行的进程可能都在; 句柄失效时, 提案退回重新执行. RFC 中还有主动断开后等待原进程完成的分支, 上面的代码展示了崩溃恢复的主要路径.
轨迹重放: 执行记录中的动作#
SWE-agent 的轨迹文件保存了每一步的模型响应(response)、从响应中解析出的思考(thought)和动作(action), 以及执行后得到的观察(observation)和环境状态(state). 其中的 query 还记录了当时发给模型的消息, 供后续检查.
重放实现会从历史消息中取出 assistant 的内容; 使用函数调用时, 还会取出对应的 tool_calls. 它将这些记录交给一个重放模型, 按顺序返回给 Agent 循环. Agent 再解析其中的动作, 在环境里执行, 得到新的观察. 下面的伪代码展示这个过程:
recorded_responses = []for message in trajectory.history:    if message.role == "assistant":        recorded_responses.append({            "content": message.content,            "tool_calls": message.tool_calls,        })
for response in recorded_responses:    action = parse_recorded_response(response)    observation = environment.execute(action)    new_trajectory.append(response, action, observation)
这里的”重放模型”依次返回记录中的 assistant 消息, 不会向待测模型发起新的请求. 原来的模型输入和响应仍可用于查看当时的决策; 这次执行产生的观察来自当前环境. SWE-agent 的这条路径主要用于生成演示轨迹和调试工具, 但是不能确保重放的结果保持一致. 因为初始文件、依赖或外部服务发生变化, 都可能让同一系列动作产生不同结果.
这些方案涉及三部分状态: 模型看到的上下文、环境里的文件, 以及可能还在运行的进程. 恢复时, Agent 需要接着之前的对话工作, 看到的文件也应当处于那段对话结束时的状态. 如果原环境里还有命令正在运行, 恢复过程还需要处理这条命令.
把问题写成 RFC#
ageval 把一道题的一次执行称为 Attempt. 为了方便阅读, 后面也会叫它”一次运行”. 这次运行会依次准备环境、执行任务、评分和记录结果.
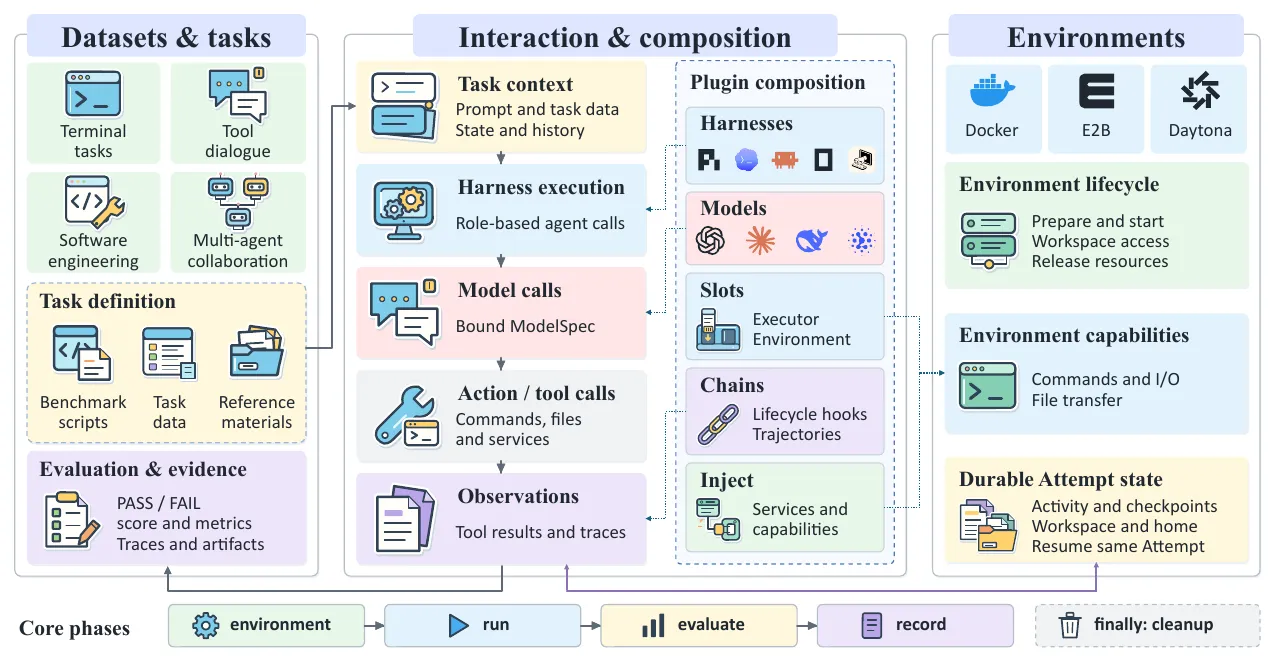
下图是我们技术报告里的框架图: 左边是任务和评测结果, 中间是任务与 Agent 的交互, 右边是执行环境. 底部列出了各阶段; 右下角的活动记录和检查点保存运行进度.
在增加恢复能力之前, ageval 会在运行结束后的记录阶段整理出完整轨迹. 查看已经结束的任务时, 这份轨迹很有用; 但如果父进程在任务执行途中突然退出, 记录阶段可能还没有开始, 轨迹也就来不及写完整.
另一个问题藏在 Agent 的一次调用里. 任务脚本可能只向 Agent 发出一次”完成这道题”的请求; Agent 接下来却会多次询问模型、读取文件、运行命令. 如果只记录任务脚本的那一次请求, 运行到第二十步时退出, 前面十九步仍然无法准确恢复.
于是我们先写了 RFC 0001, 把恢复所需的记录、环境状态和失败处理写下来, 再和 Agent 沟通设计细节. 讨论集中在步骤的完成边界、对话和文件状态的对应关系, 以及中断工具的重复执行可能产生的副作用.
接着, 我们把工作拆成 恢复功能的总 issue 和几项实现: 先处理日志、检查点和本地环境, 再接入不同的 Agent 运行程序与远程环境. 续跑完成后, 又分别实现了从检查点创建分支和终端动作重放.
一边运行, 一边保存进度#
一次运行的可恢复状态由执行记录和环境文件共同构成. ageval 分别用活动日志和文件检查点保存它们.
活动日志: 记下每一步#
运行时, ageval 会持续向 activity.jsonl 追加记录. 里面有模型调用、工具调用、会话和运行阶段等事件. 外部操作开始前, 系统先记下这一步正在进行; 等它结束, 再写下结果.
举个例子: Agent 准备执行 python test.py. 日志先记录这次工具调用开始, 然后命令运行; 命令结束后, ageval 保存文件检查点, 再写入包含输出和检查点编号的完成记录. 下面是对应顺序的伪代码, 实际实现见 ActivityLog.append:
log.append(request_id, status="in_flight", command=command)result = environment.execute(command)
seq = log.reserve_next_sequence()checkpoint = save_files(environment, seq)log.append(request_id, status="completed", seq=seq,           output=result.output, checkpoint_seq=checkpoint.seq)
reserve_next_sequence() 在这里用来说明顺序, 实际代码由日志写入过程分配编号, 并在写完成记录前调用检查点准备函数. 如果保存检查点时进程退出, 日志里还没有这一步的完成记录; 恢复时会把它当作尚未完成的操作处理. 完成记录中的编号则告诉恢复过程应该使用哪份文件状态.
日志也要考虑模型上下文的变化. 长会话可能经过压缩: Agent 把较早的对话总结成一段较短的内容, 随后继续工作. 恢复时需要让模型看到压缩后的摘要和后续消息; 如果把被摘要替代的旧消息也重新加回来, 上下文就会发生变化. 下一节会介绍 ageval 如何通过日志或会话文件恢复上下文.
检查点: 保存对应的文件#
日志可以告诉我们 Agent 修改过文件, 但续跑还需要拿到文件的内容. ageval 在步骤完成时保存工作目录、Agent 的 home 目录和相关产物的检查点. Agent 自己管理的会话文件可能放在 home 目录里, 保存它们有助于恢复原来的会话, 包括其中已经做过的上下文压缩.
每个检查点有一份文件清单, 记录文件路径、权限、修改时间以及文件内容的 SHA-256 值. SHA-256 会根据文件内容计算出一个固定长度的标识; ageval 用它查找保存的内容. 如果两个检查点中的文件内容相同, 它们的清单就可以引用同一份数据.
这与 Git 按内容标识和复用文件对象的思路相似. Git 用树对象和提交对象组织目录与历史; ageval 在每个检查点保存一份路径到内容标识的清单, 用于恢复当时的文件. 关于直接用 Git 保存检查点的取舍, 见附录.
下图展示两次检查点如何共用未修改的 app.py, 同时保留 test.py 的两个版本. 图中的 A、B、C 代表不同文件内容的摘要:
Loading
恢复时, ageval 读取选定检查点的清单, 按其中的摘要找到文件内容; 两次检查点中 app.py 都引用 A, test.py 则分别引用 B 和 C.
下面的伪代码展示了文件内容如何保存和复用, 以及恢复时如何按清单重建目录. 具体实现见 CheckpointStore:
def capture(sequence, directory):    entries = {}    for path in managed_files(directory):        data = read_and_filter(path)        if data is None:  # 排除不应保存的文件            continue        digest = sha256(data)        if not blob_exists(digest):            save_blob(digest, data)  # 相同内容只保存一份        entries[path.relative] = (digest, path.mode, path.mtime)    write_manifest_atomically(sequence, entries)

def restore(sequence, directory):    entries = read_manifest(sequence)    for path, (digest, mode, mtime) in entries.items():        write_file(directory / path, read_blob(digest))        set_metadata(directory / path, mode, mtime)    # 清除受管理目录中不属于该检查点的文件    remove_unlisted_managed_files(directory, entries)
不同路径的文件只要内容相同, 也可以引用同一份数据. 恢复时如果所需数据不存在, 系统会报错, 不会继续把这次恢复当作成功.
检查点的文件范围
read_and_filter 合并了源码中的读取和过滤步骤. 检查点只遍历受管理目录中的普通文件, 不跟随符号链接; 某些凭据路径会被排除, home 目录中的文本还会经过敏感信息遮盖. 因此检查点保存的是经过这些规则处理的文件状态.
不同 Agent 的会话管理方式也不同:
- 对于由 ageval 在宿主进程里管理的对话, 恢复时会读取日志中最近一次完成的压缩记录, 用摘要替代记录中指定的旧消息, 再接上之后的模型回复和工具结果.
- 有些 Agent 在环境内维护自己的会话文件, 恢复时则使用检查点中的会话文件继续, 由该 Agent 恢复压缩后的上下文.
无论采用哪种方式, 恢复后的工作目录都需要反映会话中已完成的操作.
Resume: 中断后接着跑#
先看最直接的场景: 评测还没写出最终结果, 父进程就退出了. 重新启动时, ageval 先检查这次运行的配置是否仍然匹配, 再判断原环境的状态.
下面的流程图展示配置检查与环境恢复的路径:
Loading
判断能否接回环境时, ageval 不只检查容器是否还在, 还会核对环境身份和环境内记录的进度. 下面的伪代码展示了环境探测、接回和重建的判断过程, 具体实现见 classify_environment:
probe = environment.probe(saved_handle)if probe.is_busy:    probe = wait_until_idle_or_deadline(probe)    if probe.is_busy:        return "busy"
if same_environment(probe, log):    # 工具在父进程退出后完成,收回它的结果    if probe.last_exit_matches_inflight_tool(log):        attach(probe)        record_finished_tool_and_checkpoint(probe.last_exit)        return "attached"    if probe.cursor == log.last_completed_checkpoint:        return attach(probe)
return rebuild_and_restore_latest_checkpoint(log)
其中有一个容易遗漏的情况: 父进程退出时, 工具命令还在原环境里运行; 等恢复时检查, 它已经结束了. 如果环境保存的命令结果能和日志中未完成的调用对上, ageval 可以接回环境, 补记输出和检查点. 否则, 环境身份或进度不一致时, 就重新创建环境并恢复最近的检查点. 重建还会重做必要的环境准备操作, 再恢复文件. 已经完成的调用会使用记录中的结果.
如果环境里的操作仍在运行, 恢复过程会先等待; 到达适用的截止时间后仍然忙碌时, 会退出并保留未完成状态, 避免同时启动另一份执行. 没有可用截止时间时, 会等待环境空闲. 对于未能收回结果的中断步骤, ageval 会根据调用类型和工具的重试许可决定下一步. 下面的伪代码展示了这些分支:
if interrupted_step.kind == "model_call": mark_aborted(interrupted_step) resend_model_call()elif interrupted_step.replay_safe: rerun_tool()else: return_interrupted_result(interrupted_step.partial_output)只有明确标记为可安全重复的工具才会自动重试; 其他工具会把中断信息和已有输出交回 Agent. 文件检查点无法撤销已经发生在环境外部的副作用, 例如已经发出的网络请求.
续跑要求原运行尚未结束, 且当前配置与原配置匹配. 整套评测恢复时, 已经结束的题目保持原有结果. 恢复后的运行仍会计入此前消耗的时间和调用次数, 以免反复中断改变原有的资源限制.
Fork: 从同一进度比较不同模型#
续跑实现后, 保存的对话和文件还提供了一个实验机会: 让不同模型从同一进度继续执行.
假设模型 A 已经读过题目、浏览过仓库并写出初稿. 我们可以选一个合适的检查点, 让模型 B 从同样的文件和会话进度出发, 再比较它们各自如何完成剩下的任务. 这个操作叫 fork, 即从已有进度创建一条新的运行分支.
Fork 会创建新的运行和新的环境, 保留原运行的来源信息. 下面的伪代码展示了从检查点创建新运行的过程; 配置校验的实现见 prepare_fork:
cut = find_checkpoint(parent, sequence)require(cut.is_forkable)require(only_solver_model_changed(parent.config, child.config))
child = create_attempt()child.copy_history_until(parent, cut)environment = create_fresh_environment(child)restore_files(environment, cut.checkpoint)continue_with_model(child, environment, new_model)
选定位置必须是可分支的完成状态. 新运行继承该位置之前的活动记录和检查点, 再在新环境中恢复文件; 它不会接回原运行的环境. 当前实现支持固定 Agent 运行程序下的单会话分支, 多角色分支还需要进一步实现. 模型不同, 也可能导致之后的行为和成本不同, 因此共同的前半段用量会单独记录.
分支结果记录了它来自哪次运行、哪个检查点, 以及模型配置发生了什么变化. 默认的从头运行统计会排除这类分支, 避免把共享前半段的结果当成独立完成整题的样本.
Replay: 重做记录过的终端动作#
Fork 还会让模型继续做决定. 另一种需求是: 不再询问模型, 只把已经记录的命令重新执行一遍, 看看新环境会出现什么结果.
这就是 replay. ageval 根据保留下来的动作记录创建一个干净环境, 按顺序执行终端动作, 保存这次的输出, 并和原记录比较. 下面的伪代码展示了执行动作、比较输出和发现差异后停止的过程, 具体实现见 replay_exec.py:
for action in recorded_actions:    actual = execute_terminal_action(environment, action)    save_new_observation(action, actual)
    difference = compare(action.recorded_result, actual)    if difference:        # 保存首次差异并停止执行后续动作        record_first_difference(difference)        break
compare_collected_artifacts_if_actions_match()
每一步使用新环境产生的输出, 与原记录中可用的退出码和输出比较; 发现第一个有意义的差异后, 动作重放停止. 输出比较会先做规范化处理; 如果动作都匹配, 收集产物后还会检查产物差异. 重放也可以对新产物评分.
重放能帮助排查某个命令或产物, 也能检查一段已记录的执行过程在新环境里是否得到相同结果. 它依赖任务初态和动作记录: 网络响应、时间、依赖版本或外部状态发生变化, 都可能让结果不同. 终端命令如果会访问外部服务或修改环境之外的数据, 重放时也会再次产生相应操作.
当前实现覆盖 miniswe 的终端动作; 其他 Agent 的终端适配和任务自定义工具的重放需要另外支持. 重放结果同样记录来源, 也不会默认混入从头运行的模型评测统计.
总结与后续工作#
三种操作使用同一套执行记录, 各自处理不同的需求:
| 操作 | 起点 | 下一步 |
|---|---|---|
| Resume | 未完成运行的可恢复进度 | 继续同一次运行 |
| Fork | 保留下来的可分支检查点 | 创建新运行, 让选定模型继续 |
| Replay | 保留下来的终端动作和任务初态 | 在新环境中重做动作、比较结果 |
这套机制的恢复效果和运行开销还需要通过实验测量. 我在技术报告中计划了父进程中断、环境丢失和工具执行中断等故障注入实验, 用来衡量恢复成功率、恢复耗时等指标. 这些实验还待完成. 能否复用现成的 benchmark, 以及专门构建一套测试的成本, 也需要进一步评估.
多角色 fork、更多 Agent 的动作重放, 以及任务自定义工具的重放, 也留给后续工作. 对于任务自定义工具, 我还想参考 agentenv-framework, 把目前由 SDK 管理的工具改为通过 Python 编写的 MCP (Model Context Protocol) 服务提供.
 agentenv-framework
附录#
为什么不用 Git 保存检查点#
Git 可以保存文件在不同时刻的状态. 平时我们用 git add 把选定的修改放进暂存区, 再用 git commit 创建一次提交. 每个提交指向当时的目录和文件内容, 也记录它的父提交; 之后可以用 git diff 查看变化, 或从某个提交取出文件.
沿着这个思路, ageval 可以在每次工具调用结束后保存一个 Git 提交, 再把提交 ID 写入活动日志. 恢复时, 日志给出进度, Git 提供对应的文件版本. 下图展示这一方案中提交与活动日志的关系:
Loading
Git 能提供文件版本和差异查看能力. 但是要用于评测恢复, 在处理任务仓库、会话文件持久化、文件权限变更检查和敏感信息过滤等方面还有所不足.
-
检查点不能随意写进任务自己的 Git 历史. 代码题的工作目录可能已经是 Git 仓库, Agent 也可能用
git status、git log和git commit完成任务. 如果把每一步检查点提交到这个仓库, Agent 看到的历史和状态就会改变. 可以为快照另建仓库, 但普通git add遇到内层仓库时, 会记录指向内层提交的条目, 内层未提交的修改不会自动进入外层快照; 被忽略的文件和内层.git数据也需要明确处理. -
恢复进度还需要工作目录之外的文件和活动日志. 有些 Agent 把完整的会话记录写在 home 目录里, 恢复上下文时需要这些文件; 相关产物也可能位于另一目录. 使用独立 Git 仓库时, 需要把这些文件纳入快照, 并把提交 ID 写入对应的日志记录. 如果文件提交已完成而日志还没写完, 恢复过程还要判断这个提交是否属于已完成的工具调用.
-
Git 保存的普通文件模式无法覆盖评测可能检查的所有权限变化. 它能记录可执行位的变化, 却无法区分
0640和0600这样的权限; 如果题目检查这些权限, 就需要额外保存信息. ageval 的检查点记录普通文件的权限位和修改时间, 恢复时重新设置它们. 当前检查点也有自己的范围: 不跟随符号链接, 也不保存所有操作系统元数据. -
保存 home 目录时, 凭据和敏感信息需要在写入存储前处理. 当前实现会排除部分凭据路径, 并对 home 文本做敏感信息遮盖. 使用 Git 存储时同样需要先过滤文件, 因为提交后再删除文件, 旧内容仍可能留在历史对象里.
因此, Git 可以作为文件快照的存储后端, 日志关联、快照范围、权限和过滤规则仍需要由评测系统处理. 当前检查点把这些需求放进同一套实现; 两种方案的性能和维护成本还需要通过实验比较.